第 3 篇·P19·v3.0
当语言模型居民比简单代码饿死得更多:人工社会中的记忆、稀缺与存活
在食物受限的世界中,由 DeepSeek-V4.1-Flash-1017 控制的居民在全部 30 个世界里福利都低于两种基线控制器;私有记忆改变了计划,但没有改变福利。
SHING CIVITAS 研究系列 · 第 3 篇 · 研究 P19 · 3.0 版,文献与模型信息修订,2026-11-12 · 状态:经负责人决定,2026-11-12 于 SHING CIVITAS 官网发布;未经外部同行评审;第 12 节披露第三方合同风险
tick、世界、随机种子、实验臂和控制器等术语在导论中已有说明。P19 实际调用 DeepSeek API 模型名 deepseek-flash。按提供方 2026-10-17 的官方公告,该入口对应 DeepSeek-V4.1-Flash-1017;归档未保存不可变的模型快照标识。
1. 标题与摘要
摘要
语言模型智能体常被展示在模拟小镇中做计划、保存记忆,但这些演示很少让计划面对饥饿与死亡。
在 P19 中,60 个模拟世界中每个世界的三名成年居民(“焦点成人”),在 60 个 tick 预热后的 180 个 tick 里,由四种控制器之一控制:带私有记忆的 DeepSeek-V4.1-Flash-1017(API 名称 deepseek-flash;llm_mem)、同一模型但无记忆(llm_nomem)、学习型控制器 mind9(m9)和旧的效用表(old)。两个世界分别是食物受限世界(F2a_cap2,食物容量 2)和富足世界(C,容量 10),各有 30 个配对种子(19911–19940),共 240 次运行(120 次为付费运行)。语言模型只获得居民可以合法感知和记住的信息,返回简短的带类型计划,由引擎验证并执行。主要结局 W 是三名焦点成人在 180 个 tick 内的平均能量,死亡计为零(0–100 尺度;不是存活百分比)。七项预注册检验(世界为单位;精确符号检验;基于种子配对的自助法 95% 区间;Holm 校正)在确认种子运行之前冻结。
在受限世界中,llm_mem 的 W 低于 m9(−26.696,95% CI −31.074 到 −22.306)和 old(−38.195,−44.177 到 −32.327),在全部 30 个世界都如此(Holm p = 1.3×10⁻⁸);记忆没有改善福利(llm_mem − llm_nomem +1.813,−0.807 到 4.457;不支持)。在富足世界中没有任何比较得到支持。一项把记忆从提示中去掉的探针发现,它改变模型计划的频率高于简单重新采样(+0.158,95% CI 0.096 到 0.221;60 个世界;Holm p = 6.3×10⁻⁵)。受限世界中每个世界的死亡数为 2.467(llm_mem)、2.633(llm_nomem)、1.533(m9)和 1.033(old);主要死因是饥饿。
对这一模型、提示词、规划间隔和行动接口而言,在食物稀缺时,语言模型居民对行动的分配比两种简单控制器更差,私有记忆改变了计划却没有改善福利。该结果特定于这一配置,不是对语言模型的排名,也不是关于人类的陈述。
关键词语言模型智能体人工社会记忆稀缺存活配对种子实验
2. 研究背景
大语言模型已被放进模拟环境,在其中计划、记忆和互动:一个带有记忆、反思与计划的“生成式智能体”沙盒小镇 [1],一个可持续合作因模型而异的渔业公共资源场景 [2],会形成共同约定的模型智能体群体 [3],以及由模型替代人类决策者的经济学实验 [4]。这些研究展示了此类智能体能说什么、能协调什么。一个更窄的问题是:当世界强制执行饥饿、稀缺、疲劳和可执行行动规则时,一个读来通顺的计划是否也能让智能体活下来。流畅的文字既不会补满库存,也不会缓解饥饿。
SHING CIVITAS 提供了一个受控的提问方式:同样的身体、同样的世界快照、同样的饥饿和同样的行动规则,可以交给语言模型,也可以交给两个透明的基线。mind9(导论第 4 节)是一个有界学习者,按行动的即时身体后果给行动定价;旧表带有固定效用。P19 追问:(Q1)在稀缺与富足的世界中,语言模型居民在福利与存活上与这些基线相比如何;(Q2)私有记忆是否改变福利;(Q3)记忆内容是否真的进入了决策。
3. 研究问题与假设
七项主要检验在任何确认种子运行之前冻结(对全部七项做 Holm 校正)。W 检验是双侧的;记忆探针检验是单侧的。
| 编号 | 假设 | 对比与结局 |
|---|---|---|
| H1(每个世界) | 带记忆的语言模型福利与 mind9 不同 | W(llm_mem) − W(m9),F2a_cap2 与 C |
| H2(每个世界) | 带记忆的语言模型福利与旧表不同 | W(llm_mem) − W(old),F2a_cap2 与 C |
| H3(每个世界) | 记忆改变福利 | W(llm_mem) − W(llm_nomem),F2a_cap2 与 C |
| H4 | 记忆内容进入决策 | 去掉记忆时计划发生变化的比例,减去对同一提示重新采样时发生变化的比例(> 0;60 个世界合并) |
得到支持要求 Holm p < 0.05,且 95% 区间在同一方向上不含零。由于前三项是双侧的,没有预测方向。次要的、未校正的描述包括死亡、时间分配、采集产出、偷窃、给予、制造、成本、延迟和模型计划的有效性,另外还区分了预训练知识(第一次计划)、提示内推理(llm_nomem)和学习(仅在有记忆时出现的差异)。
4. 研究设计
模型来源与可核对版本。 P19 冻结协议及报告记录的实际 API 模型名是 deepseek-flash,采用非思考模式、JSON 输出、temperature 0.7、max_tokens=700。DeepSeek 官方 2026 年 10 月 17 日公告称,该接口名称已对应 DeepSeek-V4.1-Flash-1017[6]。实验于 2026 年 11 月 6 日进行;这一具体版本判断基于实验时间与官方路由变更记录,不等于归档中保存了不可变的模型快照 ID 或返回的构建哈希。本实验没有测试后续计划中的 DeepSeek V4 Pro。本文为独立研究比较,不代表模型提供方背书。
世界。 F2a_cap2(受限;食物容量 2;其余居民为 mind9)与 C(富足;容量 10;在 P18 中,付费制造有害,且携带上限使工具的增益为零)。确认种子 19911–19940,每个世界 30 个配对种子,共 60 个世界。对每个世界,tick 60 的快照服务于全部四个实验臂;焦点居民是 tick 60 时 ID 最小的三名健康成人。观察窗口为 tick 60–240(180 个 tick,覆盖两个冬季的大部分)。
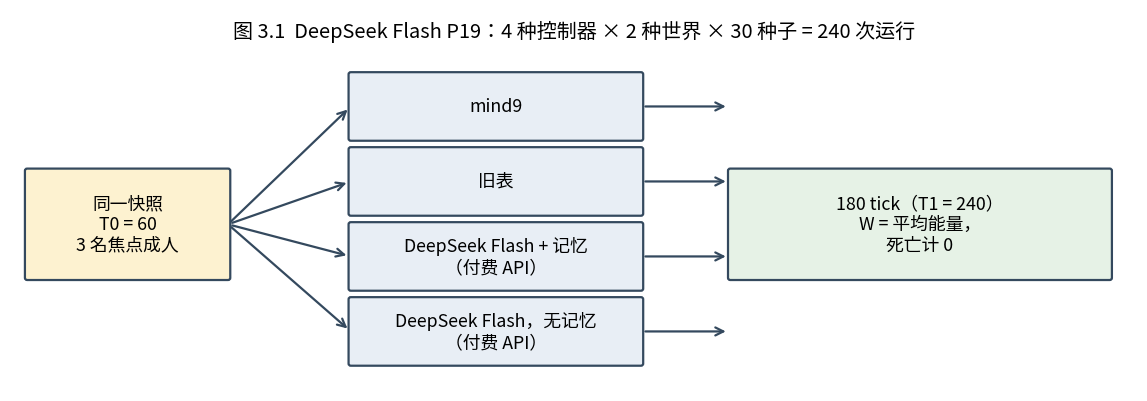
deepseek-flash;版本依据官方当期更新记录,原始归档未固定不可变快照)。控制器。 m9 与 old(免费;与双生世界核对过)。语言模型实验臂使用 DeepSeek-V4.1-Flash-1017(API 名称 deepseek-flash),关闭思考模式,输出 JSON,温度 0.7,输出上限 700 个 token。每次调用不是每个 tick 一次,而是返回一个最多八步(约 12 个 tick)的带类型计划。世界在执行时验证每一步,并在计划结束、某一步不可行、居民被盗、患病或康复、能量低于 25,或工具损坏时再次调用模型。模型决定做什么、对谁、多少、在哪里:go{x,y} 前往记得的某个格子(采集发生在居民所站的格子上)、approach、give{to, amount}、socialize、steal。后果(发现、信任、惩罚、核算)由引擎施加。
合法视图。 提示中只包含:居民的身体、库存和工具;它记得的格子(含观察时间;可能已过时);视野内的人及其可见能量等级;它自己的信任值与家庭;发生在它身上的事件(未被看到的窃贼保持匿名);以及日历。不含其他居民的库存、特质或想法,也不含全局地图。行动说明给出语法和前提条件(“3 木材 → 工具”),但不给出效果大小。
记忆操纵。 llm_mem 保留自己的笔记(最多六条)、目标、最近十步的结果,以及一张记录自己在有工具和无工具时采集结果的表。llm_nomem 去掉全部记忆,只看到最近六个 tick 内发生的事件。
记忆探针。 对每次 llm_mem 运行,把已包含居民自身经验的四个决策各再问两次:一次用同一提示(重新采样),一次去掉记忆。行动集合发生变化的计划所占份额之差,估计的是进入决策的是记忆内容而不是采样噪声的程度(60 个配对世界)。
验证。 每次付费运行都由记录下的回复离线重放;每个 tick 的状态哈希必须匹配(120 次中 120 次匹配)。
开发历史(已披露)。 开发种子 19901/19902 在确认种子之前使用。在第一次开发运行中,三名模型居民全部饿死(tick 101、113 和 140),而在同一快照下,mind9 和旧表三人全部存活。在确认种子之前,在提示和记忆中(而不是世界中)发现并修复了两处缺陷:提示曾陈述一条错误规则,称居民在能量低于 75 时会自动吃一份食物(引擎只吃整份,所以持有不足一份的居民无法进食);记忆只记录食物和木材的变化,没有记录每个行动带来的能量、疲劳和睡眠压力后果。工具的效果被刻意不加说明。因此确认结果反映的是修复后的提示;第一版提示的失败是关于提示敏感性的证据。
5. 变量与操作化
| 变量 | 角色 | 操作化定义 | 单位 |
|---|---|---|---|
| 控制器实验臂 | 自变量 | m9、old、llm_mem、llm_nomem | 分类 |
| 世界条件 | 自变量 | F2a_cap2(受限)对 C(富足) | 分类 |
| W(焦点福利) | 主要因变量 | 焦点能量总和 ÷(3 名居民 × 180 个 tick);死亡计为 0 | 能量单位,0–100 |
| 每世界死亡数;饥饿死亡数 | 次要 | 焦点死亡(全因;仅饥饿,与年龄/疾病风险分别记录) | 每世界死亡数(3 名焦点成人) |
| 存活人·tick | 次要 | 焦点居民存活的 tick 数 | 每实验臂的人·tick |
| 时间分配 | 次要 | 焦点居民 tick 在各类行动(采集、睡眠、移动、砍柴等)上的份额 | 比例 |
| 采集产出 | 次要 | 每次采集行动获得的食物 | 食物单位/行动 |
| 计划变化率(探针) | 主要(H4) | 再次询问的决策中,所计划的行动集合发生变化的比例 | 比例 |
| 请求数、成本 | 描述性 | 记录的请求;按存档的高峰价格计算的成本 | 次数;美元 |
| 控制 | 固定 | 每个世界相同的快照和焦点居民;相同的行动接口;180 个 tick | — |
6. 样本与实验单位
30 个配对种子(19911–19940)× 2 个世界 × 4 个实验臂 = 240 次运行(120 次付费)。每次运行有三名焦点成人,所以付费运行共 360 个、总共 720 个焦点居民实例;这些实例和 180 个 tick 是嵌套的重复测量,不是独立样本。 推断单位是配对世界(每个世界条件 n = 30;探针合并两个世界为 60)。没有任何运行被排除;全部 120 次付费运行的重放都完全一致。开发种子 19901 与 19902 在确认集之外。
7. 方法与统计分析
对每个世界,计算两个实验臂之间 W 的配对差值。我们报告平均差值(能量单位)、95% 百分位自助法区间(对世界重抽样 10,000 次)、精确双侧符号检验(舍去零差值),以及七项冻结检验的 Holm 校正 p 值;探针对配对的计划变化差值使用单侧符号检验。W 是有界的,并对死亡居民计零,所以均值混合了存活与存活者的能量。“得到支持”要求 Holm p < 0.05 且区间不含零。次要量(死亡、时间分配、产出)是描述性的,未经校正。
8. 结果
8.1 福利(W)
表 3.1 各实验臂和世界的平均 W(能量单位,0–100;每格 30 个世界;描述性)。
| 实验臂 | 受限(F2a_cap2) | 富足(C) |
|---|---|---|
| llm_mem | 24.926 | 75.803 |
| llm_nomem | 23.113 | 76.471 |
| m9 | 51.622 | 78.023 |
| old | 63.121 | 73.393 |
表 3.2 P19 主要检验(每项 n = 30 个配对世界,探针 n = 60;七项 Holm 校正)。
| 检验 | 对比 | 平均差值 | 95% CI | 符号检验 p | Holm p | 是否支持 |
|---|---|---|---|---|---|---|
| H1,受限 | llm_mem − m9 | −26.696 | [−31.074, −22.306] | 1.86×10⁻⁹ | 1.30×10⁻⁸ | 是 |
| H2,受限 | llm_mem − old | −38.195 | [−44.177, −32.327] | 1.86×10⁻⁹ | 1.30×10⁻⁸ | 是 |
| H3,受限 | llm_mem − llm_nomem | +1.813 | [−0.807, 4.457] | 0.200 | 0.802 | 否 |
| H1,富足 | llm_mem − m9 | −2.219 | [−3.965, −0.717] | 0.362 | 1 | 否 |
| H2,富足 | llm_mem − old | +2.410 | [−0.159, 5.014] | 0.585 | 1 | 否 |
| H3,富足 | llm_mem − llm_nomem | −0.668 | [−2.298, 0.824] | 1 | 1 | 否 |
| H4,探针 | 去掉记忆 − 重新采样的计划变化率 | +0.158 | [0.096, 0.221] | 1.27×10⁻⁵ | 6.33×10⁻⁵ | 是 |
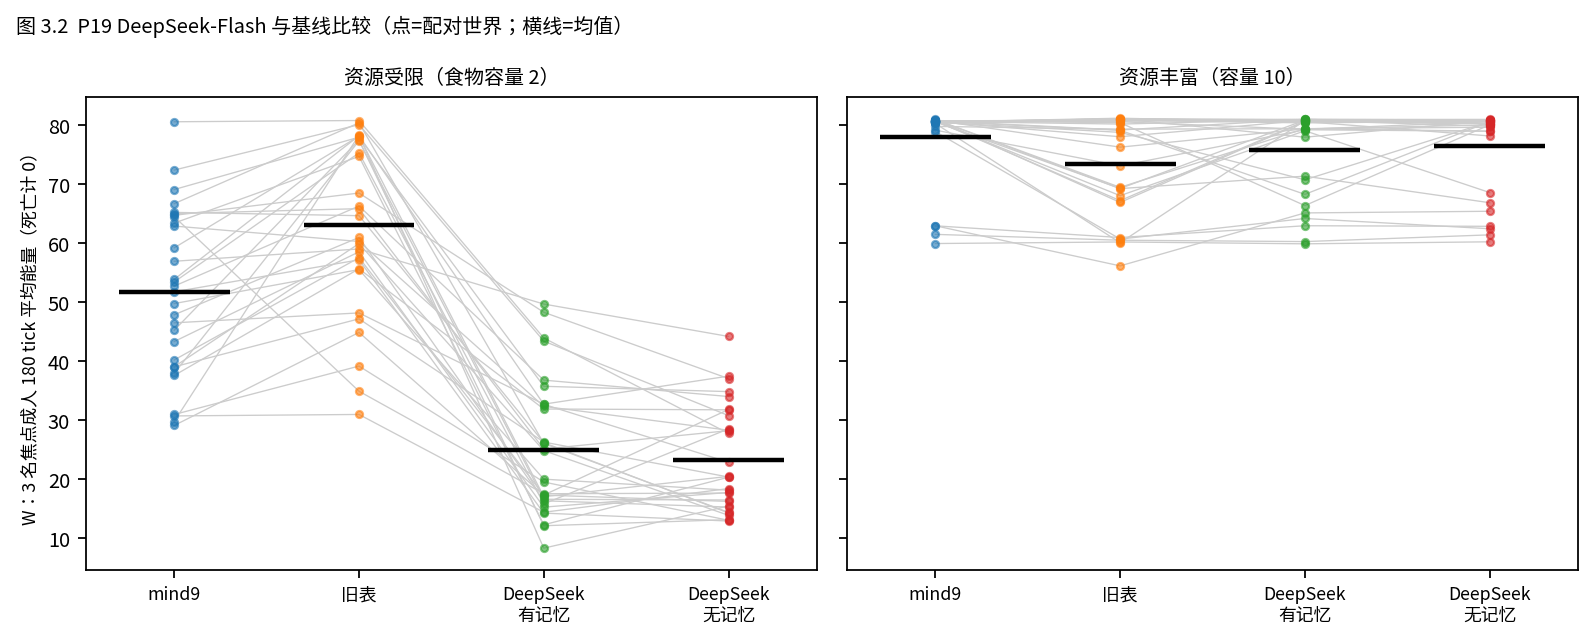
deepseek-flash;版本依据官方当期更新记录,原始归档未固定不可变快照)。解读。 H1 与 H2(受限):在全部 30 个世界中,由模型控制的居民的平均能量(死亡计 0)都低于 mind9 和旧表,在 0–100 的尺度上分别低约 27 和 38 个能量单位;区间远离零,符号检验一致(30 个中没有一个对语言模型有利)。H3:有无记忆的差异很小、为正,其区间跨越零,所以记忆没有明显影响福利。富足世界:区间大多在零附近;对 H1,区间(−3.965 到 −0.717)不含零,但符号检验在校正后未达显著,所以按冻结规则不支持;约 2 个能量单位的平均差值相对于受限世界的差距很小。H4:去掉记忆后,模型的计划发生变化的频率比重新采样高约 16 个百分点(34 个世界更高、7 个更低;其余世界相同),所以记忆内容确实进入了决策过程。这并不表明福利有所改善,也不表明模型从经验中学到了因果规则。
8.2 死亡
表 3.3 每个世界的死亡数(每个世界 3 名焦点成人;每格 30 个世界;描述性)。
| 实验臂 | 世界 | 全因死亡 | 饥饿死亡 | 年龄/疾病死亡 | 期末焦点存活(共 90) |
|---|---|---|---|---|---|
| llm_mem | 受限 | 2.467(共 74) | 2.400(72) | 0.067(2) | 16 |
| llm_nomem | 受限 | 2.633(79) | 2.467(74) | 0.167(5) | 11 |
| m9 | 受限 | 1.533(46) | 1.400(42) | 0.133(4) | 44 |
| old | 受限 | 1.033(31) | 0.867(26) | 0.167(5) | 59 |
| llm_mem | 富足 | 0.367(11) | 0.200(6) | 0.167(5) | 79 |
| llm_nomem | 富足 | 0.300(9) | 0.133(4) | 0.167(5) | 81 |
| m9 | 富足 | 0.200(6) | 0.033(1) | 0.167(5) | 84 |
| old | 富足 | 0.600(18) | 0.467(14) | 0.133(4) | 72 |
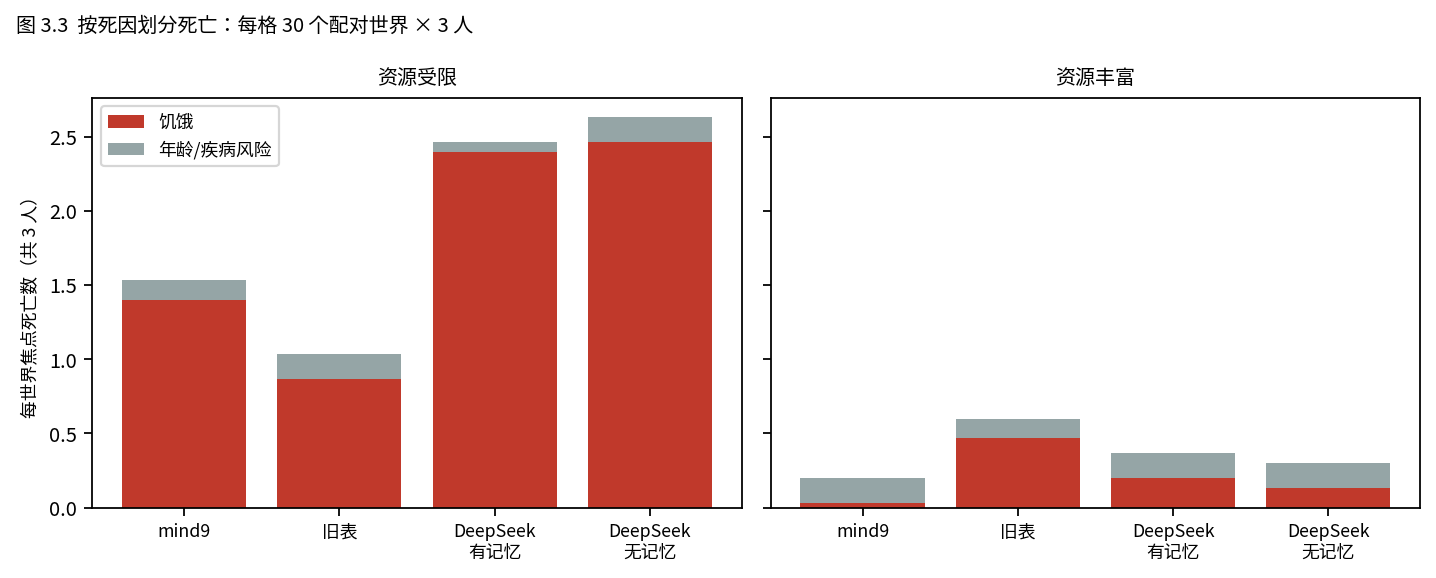
deepseek-flash;版本依据官方当期更新记录,原始归档未固定不可变快照)。解读。 每个世界有三名焦点成人,2.467 的每世界死亡数意味着,在受限世界中,使用带记忆语言模型的焦点成人平均约有 82% 在 180 个 tick 内死亡(90 个中的 74 个),而 mind9 为 51%,旧表为 34%。本研究最初的书面摘要报告“每个世界 2.5 名饿死的居民”,混淆了分母;单独的合计数(85 例死亡、78 例饥饿死亡)是把 llm_mem 在两个世界(180 名焦点成人)上汇总的,不能只除以受限世界的队列;“每个世界约 2.3 例饥饿死亡”的数字已被撤回。富足世界的死亡率对所有实验臂都低;旧表在那里死亡最多(18 例,其中 14 例饥饿),这只是描述性的。
8.3 居民做了什么?(探索性分解)
表 3.4 受限世界中的时间与产出(焦点居民 tick 的份额;每次采集行动获得的食物单位;描述性)。
| 实验臂 | 采集 | 睡眠 | 移动(go) | 每次采集行动的食物 |
|---|---|---|---|---|
| llm_mem | 0.386 | 0.316 | 0.204 | 0.491 |
| llm_nomem | 0.373 | 0.252 | 0.239 | 0.504 |
| m9 | 0.695 | 0.247 | — | 0.423 |
| old | 0.536 | 0.214 | — | 0.546 |
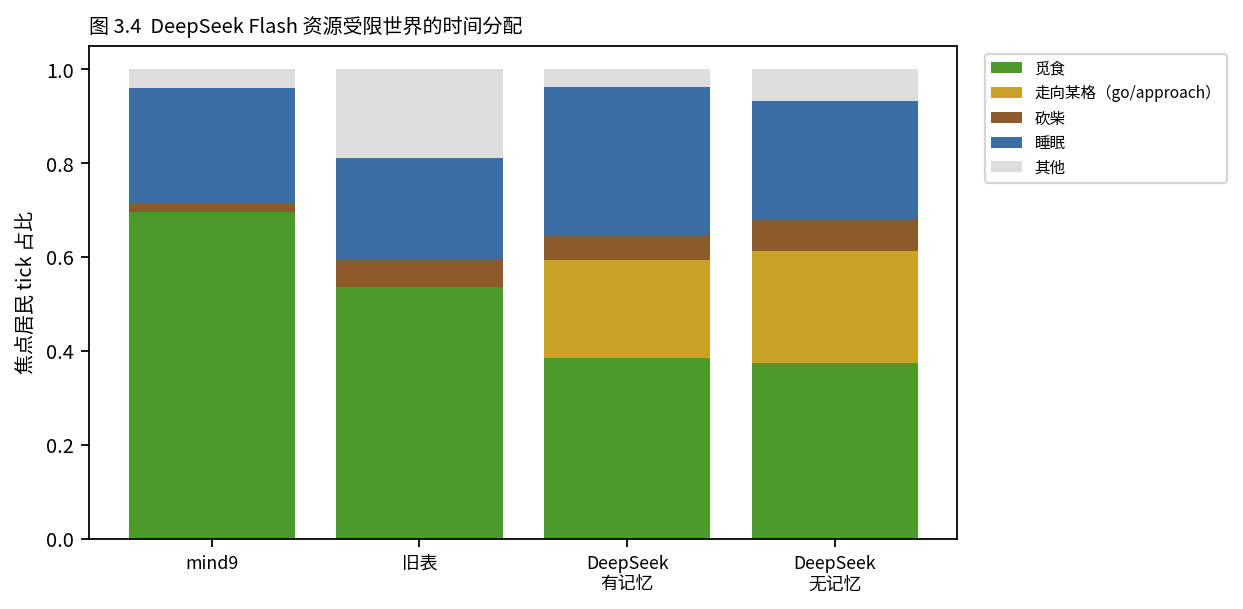
deepseek-flash;版本依据官方当期更新记录,原始归档未固定不可变快照)。语言模型居民约有 37–39% 的 tick 用于采集,而 mind9 约为 70%,同时他们有五分之一到四分之一的 tick 花在格子之间移动;就每次采集行动而言,他们的产出(0.49–0.50 食物单位)并不低于 mind9(0.42)。一个合理的解释是,福利差距源于时间分配,而不是不会采集。时间分配没有被随机化,所以这是假设,不是已证明的原因;分解文件中 m9 和 old 没有 go 条目,所以这些格子留空。也记录到一些较小的效应:语言模型实验臂的居民很少偷窃,有时会给出食物或储存木材;这些在社会上讨喜的行动并没有转化为更好的存活。
8.4 有效性、成本与执行
全部 8,034 次请求(8,029 次成功,5 次失败)均有记录,按存档的高峰价格核算,估计费用为 2.833641 美元(不是经核实的提供方账单)。全部 120 次付费运行重放时,逐 tick 状态哈希完全一致。591 个计划步骤在执行时不可行,被执行器拒绝。原协议把请求上限设为 200 次、成本上限为 5 美元;在运行确认种子之前,项目负责人取消了成本上限,多世界协议(v2)在没有该上限的情况下冻结,而实际请求数远远超过 200 次。这是对试运行阶段协议的一项已披露的偏离,而不是对冻结的确认性协议的偏离。
9. 讨论
显示了什么。 在稀缺条件下,由语言模型驱动的居民,只被给予对世界的合法视图和带类型计划的行动,其福利损失大于由任一基线驱动的居民,并且在 30 个世界中的每一个都如此。在富足条件下,差异很小且在噪声之内。因此,这一结果是关于世界的稀缺程度与决策过程的行动分配之间的交互:当错误代价低时,计划足够好;当食物稀缺、每个 tick 都重要时,分配就重要了。
记忆。 探针表明记忆块被使用了。福利比较表明,在这一实现中,使用并没有转化为可测量的收益。这与若干数据无法区分的解释一致:记忆内容的信息量可能不够,模型可能没有从中得出正确的结论,或者收益可能小到用 30 个世界无法检测(区间 −0.8 到 +4.5)。
提示敏感性。 开发历史本身就有信息量:提示中一句关于居民何时进食的错误陈述,加上记忆里缺少身体后果,共同导致了早期的死亡。语言模型智能体在模拟中的结果,应当被读作关于“模型加提示加接口”这一系统的结果。
与既有研究的关系。 早先的语言模型模拟报告了流畅的计划和社会协调 [1–3];P19 增加了一个例子:同类智能体与严酷的生存经济匹配不佳。不应把它读作与那些研究相矛盾,那些研究使用的是不同的任务、模型和成功标准。
10. 局限
- 一个模型、一套提示、一种规划节奏、一个接口; 结果不是对语言模型的排名,对其他模型、版本或提示未必成立。提示是在开发失败之后修复的。
- 每次运行三名焦点成人; 其他居民是 mind9。嵌套测量不是独立的。
- 时间分配没有被随机化; 第 8.3 节的机制是合理但未经证明的原因。
- 记忆设计只是一种实现; 福利效应为零并不说明记忆无用。
- W 把存活与能量混在一起。
- 富足世界的比较: H1 区间不含零而符号检验不显著;按冻结规则报告为不支持。
- 成本数字 是按存档高峰价格的估计,不是账单;成本上限在确认之前被负责人取消。
- 单一时间窗口(180 个 tick);不能做长期或跨代推断。
- 复现仅限离线: 记录下的模型回复可以重放,但第三方无法由该包重新向模型发出查询;原始提示词和事件流不包含在内。
- 权利与治理: 原始数据包的 manifest 仍将 P19 标记为
PUBLICATION_BLOCKED;负责人已要求在知悉相关提供方合同解释风险的情况下将文章列入发布计划,数据下载上线前还需更新发布记录;预注册是内部的;协议是在负责人指导下由一个 AI 编码助手起草的(措辞待负责人确认);没有独立复现。
11. 结论
在这个人工社会中,食物稀缺时,由语言模型控制的居民的福利效率远低于有界学习者或手写的效用表(在 0–100 尺度上分别低约 27 和 38 个能量单位,在全部 30 个世界都如此),食物富足时则相当。私有记忆明显改变了模型的计划,却没有可测量地改变福利。结论仅限于所研究的配置:在这个世界里,一个连贯的计划不是存活的充分条件,差距出现在有限时间与行动的分配上,而不是流畅度上。
12. 数据可得性与可复现性
证据包 SC-P19-LLM-Residents 包含协议、报告和一份死亡率更正说明、240 次运行的逐次运行派生记录(数值 ID,不含提示文本)、公开的分析与分解 JSON、主要结果与死亡率 CSV、API 使用摘要和发布元数据。原始提示和回复、完整事件流以及凭据均不包含在内。本文所有数字都由逐次运行记录(表 3.1–3.3)和冻结的分析文件(表 3.2 和 3.4)重新计算,并且一致。原始 P19 数据 ZIP 的发布元数据目前仍标记 PUBLICATION_BLOCKED;v3 不会擅自改写原 ZIP 或此前的 manifest。负责人已明确希望将 P19 纳入公开文章并注明 DeepSeek 模型名称,且知悉相关第三方合同风险。数据 ZIP 的正式上线仍须在执行发布动作时同步更新发布记录并单独检查可访问范围;本文并不构成已上传或已开放下载的声明。由于模拟引擎、模型快照和记录下的原始回复不分发,无论是模拟还是模型调用,都无法由该包重新运行。包内名称仍使用早期名称“Emergentia”,并且该包的协议、报告和元数据点名了提供方和模型,发布时须如实披露提供方及模型身份,并将未经解决的合同解释风险留在发布记录中。
SHING CIVITAS P19 LLM 居民研究数据集
SHING CIVITAS P19 LLM Residents Dataset
在模拟世界中用第三方语言模型连续控制焦点成人的实验:冻结协议、已核验统计、逐运行队列表、API 用量聚合、分析脚本与原图,并含死亡统计更正说明。不含任何模型提示、回复原文或原始 API 账本。
数据暂缓公开。 本数据集(P19)正在完成第三方权利审查,暂不提供下载。审查通过后将在此处提供,并附许可与引用信息。
审计记录的原因(英文原文):The third-party model provider's open-platform terms forbid, without permission, any use of its trademarks, trade names or prominent brand features, expressly including its name (clause 5.2), and make such breach a fundamental breach (clause 5.4). This package names the model and provider 37 times in text files (README, environment notes, one analysis script and the protocol documents) and twice in a figure label rendered into the PNG. No written permission obtained. No verbatim model output, prompts or API ledgers are included. Data integrity and security checks passed; the block is a rights issue, not a quality issue.
参考文献
以下外部文献已于 2026-11-12 对照出版社、期刊、会议论文集、DOI 或图书馆记录核验。它们仅支撑理论背景和研究方法,不构成对 SHING CIVITAS 实验结果的外部验证。
- 1Park, J. S., O’Brien, J. C., Cai, C. J., Morris, M. R., Liang, P., & Bernstein, M. S. (2023). Generative agents: Interactive simulacra of human behavior. Proceedings of UIST ’23, Article 2, 1–22. https://doi.org/10.1145/3586183.3606763
- 2Piatti, G., Jin, Z., Kleiman-Weiner, M., Schölkopf, B., Sachan, M., & Mihalcea, R. (2024). Cooperate or collapse: Emergence of sustainable cooperation in a society of LLM agents. Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://proceedings.neurips.cc/paper_files/paper/2024/hash/ca9567d8ef6b2ea2da0d7eed57b933ee-Abstract-Conference.html
- 3Ashery, A. F., Aiello, L. M., & Baronchelli, A. (2025). Emergent social conventions and collective bias in LLM populations. Science Advances, 11(20), eadu9368. https://doi.org/10.1126/sciadv.adu9368
- 4Horton, J. J., Filippas, A., & Manning, B. S. (2023; revised 2026). Large language models as simulated economic agents: What can we learn from Homo silicus? NBER Working Paper No. 31122. https://doi.org/10.3386/w31122
- 5Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- 6DeepSeek. (2026, October 17). DeepSeek-V4.1-Flash-1017 model update (API alias
deepseek-flash). DeepSeek API change log. https://api-docs.deepseek.com/updates/
核验登记: 参见 附录 C · 文献核验登记,含各条来源链接、著录更正和核验边界。