导论·v3.0
SHING CIVITAS:研究自主智能体的人工社会实验平台
人工社会如何运转;tick、世界、种子、实验臂与分叉的含义;实验如何设计与分析,以及这些实验能说明什么、不能说明什么。
SHING CIVITAS 研究系列 · 导论 · 3.0 版(文献已核验,2026-11-12)· 状态:2026-11-12 于 SHING CIVITAS 官网发布;未经外部同行评审
摘要。 SHING CIVITAS 是一个独立研究项目:它构建一个小型人工社会,并把它当作实验室。软件居民必须寻找食物、熬过冬天、抚养孩子、交易,有时还会偷窃,并决定是否帮助他人。研究者可以在任意时刻复制整个世界、只改动一条规则,再让两个版本各自运行下去。因此,这个平台能回答一个单靠观察很难回答的问题:当某种社会现象出现时,究竟是居民自己做了决定,还是研究者写下的规则造成了它? 本文说明这个社会如何运转,几个关键术语(tick、世界、随机种子、控制器、运行、实验臂、分叉)的含义,实验如何设计与分析,以及这类实验能说明什么、不能说明什么。本系列的四篇研究文章(自主照护、工具经济、语言模型居民、有界信念)可以单独阅读,但都依赖这里引入的词汇。
阅读指引。 第 1–2 节介绍动机和研究问题;第 3–5 节介绍模拟世界、居民和替居民做决定的控制器;第 6–9 节介绍实验方法与统计;第 10 节列出局限;第 11 节概述四项研究;第 12 节说明数据可得性并列出参考文献。
1. 为什么要构建人工社会?
当研究者看着模拟村庄里孩子得到喂养、工具被制造、房子被盖起,很容易说“照护”“手工技艺”或“合作”已经“涌现”。这种说法回避了一个问题:在许多模拟中,世界引擎本身就在家庭成员之间转移食物、惩罚窃贼或分配信任。如果是引擎在起作用,结果说明的是引擎,而不是居民的决定。
基于智能体的建模长期使用人工社会来考察社会格局如何从局部规则中产生:Schelling 的隔离模型 [1]、Epstein 与 Axtell 的《Growing Artificial Societies》[2]、Axelrod 的合作研究 [3] 都是经典例子;Epstein 还主张,这类模型最有价值之处在于解释,并追问“要出现这种格局,什么必须成立”[4]。近年来,语言模型智能体被放进模拟小镇和公共资源场景 [5–8],这就引出一个新问题:当选择带来饥饿、寒冷和死亡等真实后果时,这类智能体的行为是否合理?
SHING CIVITAS 在这一文献中采取了刻意收窄的立场。它不试图复现任何真实的人类社会,而是关注归因与最低条件:
- 哪些社会结果由研究者写下的规则产生,哪些由居民的决定产生?
- 在照护孩子、制造工具或储存食物之类的行动既成为可能、又值得去做之前,居民必须合法地掌握哪些信息,世界又必须在物理上提供什么?
- 把一个通用语言模型放进同样的身体和同样的饥饿中,与平台自己的简单、透明的决策系统相比如何?
2. 研究问题
本系列各项研究分阶段回答这些问题。每个阶段都在读完上一阶段之后设计,后续阶段会明确撤回前面阶段无法支持的解释。
| 阶段 | 问题 | 文章 |
|---|---|---|
| P10–P12 | 如果引擎不再自动把食物转给孩子,居民会接手吗?决策链在哪一环断裂?一次照护行为会改变孩子的命运吗? | 第 1 篇(自主照护) |
| P17–P18 | 在什么物理条件下,工具、房屋、储备、互助和交换才有真实价值?有用的工具是否值得制造? | 第 2 篇(工具经济) |
| P19 | 如果由通用语言模型在同样的饥饿与规则下控制成年居民,它与平台自身的控制器相比如何?私有记忆有帮助吗? | 第 3 篇(语言模型居民) |
| P14 | 居民能否对孩子隐藏的食物储备持有有界的私人信念,并比更简单的规则更好地预测孩子的状况?更好的预测是否足以进入行动实验? | 第 4 篇(有界信念) |
“P”后的数字是项目内部的实验序号。更早的实验(P1–P9)和若干中间实验(P13、P15、P16)在需要时会被提及,但撰写这些文章时,只有 P10–P12、P14、P16-A/B、P17–P18 和 P19 的数据可用(见第 12 节)。
3. 模拟世界
3.1 空间、时间与资源
世界是一张方格地图。每个格子有食物和木材,二者会缓慢再生,直至每格容量上限。标准研究世界里每格食物容量为 10;“受限”世界把它设为 2(主要的实验操纵之一)。地形包括资源禀赋不同的森林和平原。
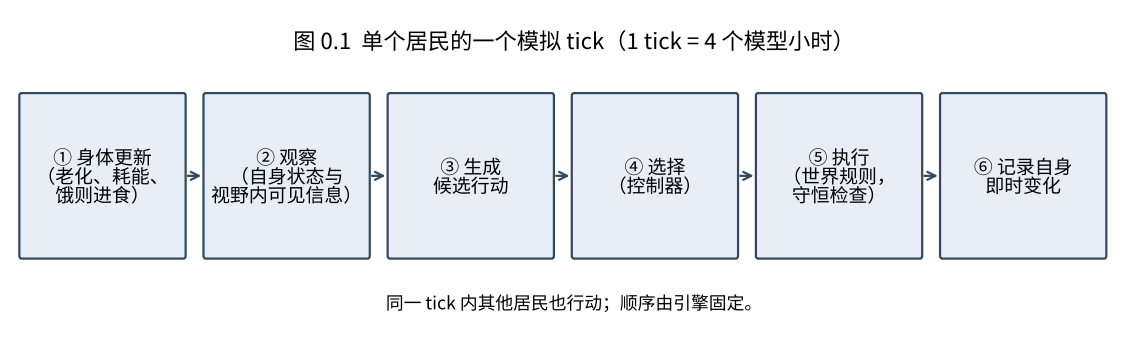
时间以离散的步进推进,称为 tick。一个 tick 代表 4 个模型小时,因此 6 个 tick 是一个模型日。项目还使用压缩历法:120 个 tick(20 个模型日)为一个模型年,其中最后 30 个 tick 是冬季。标准实验运行 480 个 tick,即四个模型年。孩子大约需要 1,680 个 tick 才成年,所以本系列没有任何实验会跟踪一代人到成熟。
3.2 身体与生存需求
每个居民有一个 0 到 100 的能量值。身体每个 tick 都会消耗能量(成年人约 3 个单位;儿童的消耗取决于年龄)。1 单位食物提供 12 能量。能量低于 75 时,居民会从自己的库存里吃一整份;不能只吃零头。居民在能量耗尽时死于饥饿,或死于引擎随机施加的年龄或疾病风险。这两类死因被分别记录,文章中从不合并。
冬季(每个模型年最后 30 个 tick)会提高生存压力;房屋和木材使用见第 2 篇。居民会因劳作而疲劳,需要休息或睡眠。携带能力有限(标准研究世界为 20 个单位),携带的食物会缓慢变质。劳动消耗能量。
分析中使用三类居民:健康成人、患病成人和儿童。按世界规则,儿童不能自己采集食物;他们的存活依赖成年人。
3.3 工具、建筑、交易与储存
木材可用于冬季取暖、建造、交易或制造工具。工具耗费三份木材和一次制造行动;它使每次采集行动的产出乘以约 1.5(增益受格子存量和携带上限截断),并在约 80 次采集行动后损坏,每次采集消耗一个耐久单位,与产量无关。居民还可以发起建造项目(例如降低冬季暴露的房屋)、以物易物、使用现金市场、发布报价,并组建家户与伴侣关系。
3.4 社会结构与制度规则
居民属于家庭和家户,结成伴侣、生育孩子,并通过亲身经验、目击和流言建立相互的信任。世界里还有一些无人做决定就会运行的规则。它们对研究问题至关重要,因此引擎对其做了明确标记:
- 自动家户分食。 在旧配置中,引擎在每个 tick 都在同处一地的家庭成员之间转移食物。
- 自动同伴惩罚。 具有惩罚倾向的居民会按一定概率惩罚窃贼;惩罚者并不做选择。
- 信任更新、伴侣与生育概率、遗产继承与孤儿收养。
相反,照护(把食物给被扶养者)、分享、社交、以物易物、偷窃、制造与建造是居民的控制器可以选择的行动。实验可以关掉某条自动规则,这是 P10 分离“居民真正决定了什么”的主要手段。
另有一些机制(例如“互助制度”和市场)在第 2 篇中处理。
4. 居民及其决策方式
这里的智能体是一个模拟居民,具有身体、库存、对所见事物的记忆、人际关系,以及选择行动的控制器。居民在一个 tick 内的回合遵循图 0.1 的循环:更新身体、观察、提出候选行动、由控制器选择、由世界按规则执行(每个 tick 都检查食物和木材守恒),最后居民记录自己的行动带来的即时身体变化。
4.1 居民可以知道什么
一个核心的设计原则是合法视图:居民的决定只能使用处于该位置的人合理可得的信息。例如,一名成人在决定是否喂养孩子时,可以使用孩子在视野内可见的状况和位置,但不能读取孩子隐藏的食物库存。本系列早期的大量工作,就是找出继承代码违反这一原则的地方,再检验修复后有什么变化(第 1 篇与第 4 篇)。平台作者明确说明,合法视图目前只在特定路径上强制执行,例如 P12 引入的照护路径,并未覆盖整个智能体。
4.2 三类控制器
- 旧表(“old”)。 手写的效用表给各类行动指定固定价值(例如给照护孩子很高的值,木材足够时偏好制造)。它能产生看似合理的社会行为,但这些行为是写进去的,所以不能证明居民发现了它们。
- mind9(“unified”)。 一个小型学习决策系统。它根据自己以前经历过的、对自身能量、食物、木材、疲劳等的即时变化,再加上一组文化先验,为每个候选行动定价。它最多检查三个候选,按熟悉度和当前需要排序,一旦有一个看起来足够好就停止(满意化 [9]),并且约 5% 的时间随机探索。从未尝试过的行动默认价值为零。因为它只从同一 tick 内的身体变化中学习,延迟的或指向他人的收益,例如工具的长期价值或孩子日后的存活,对它是不可见的。这是一个刻意受限的工程模型,不是对人类认知的论断。
- 语言模型控制器(P19)。 一个通用大语言模型接收居民可以合法看到和记住的内容的文字描述,返回一个简短的带类型计划,再由引擎逐步验证并执行(第 3 篇)。
实验“处理”还可以修改 mind9,例如加入一个提示,把视野中虚弱的被扶养者提到居民的注意中;或给未尝试的行动赋予期望水平的价值而不是零(第 1 篇);或加入一个私有信念存储(第 4 篇)。
5. 实验的词汇
| 术语 | 在 SHING CIVITAS 中的含义 |
|---|---|
| 随机种子(seed) | 一个整数,固定随机数流,进而固定初始世界:地图、居民、家庭,以及其他未受影响的随机事件序列。不同种子给出不同但统计上可比的世界。 |
| 世界(world) | 由一个种子在一种配置下产生的一个具体的模拟社会。“40 个世界”指 40 个各自独立的模拟社会。 |
| 实验臂(arm) | 一种实验条件(例如“自动分食关闭,mind9”)。每个种子通常在每个实验臂下各运行一次。 |
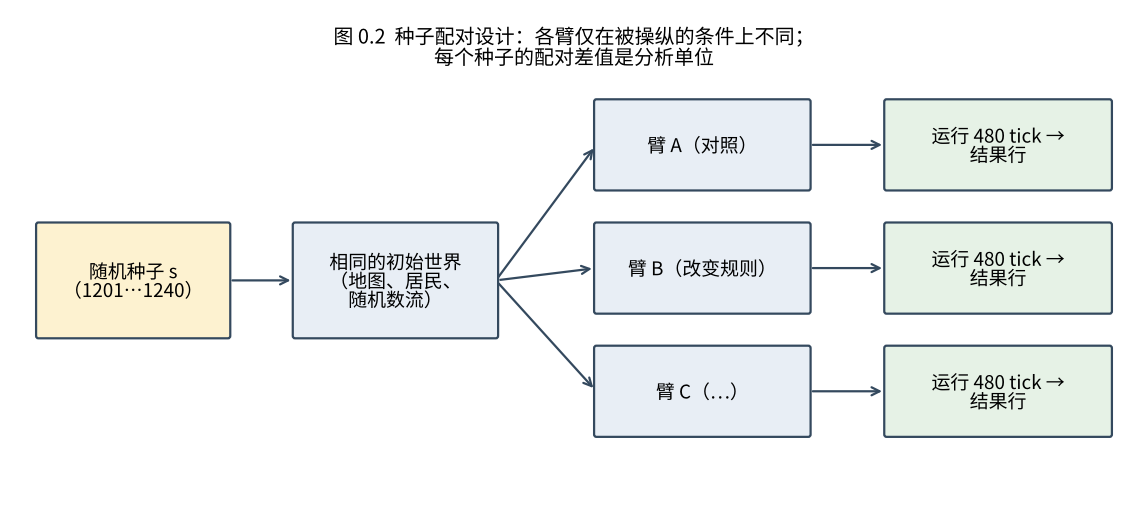
| 配对种子 | 同一个种子在多个实验臂下运行。所有实验臂从完全相同的初始世界出发,因此差异可归因于实验臂(以及由它引发的下游变化)。 |
| 控制器(controller) | 为居民挑选行动的决策系统:旧表、mind9 或语言模型控制器。 |
| 运行(run) | 一个世界在一个实验臂或控制器下从头到尾的一次执行。在 P19 中,“运行”也是记录控制器决策的单位。 |
| 快照与分叉(snapshot, fork) | 世界在某个 tick 的完整保存状态。分叉指从同一快照出发,让两份或多份副本在改变一件事之后继续运行(例如强制一名成人去照护或去休息)。 |
| 预热(warm-up) | 干预之前的时期,使世界达到有代表性的状态(P17–P19 中 T0 = 60 个 tick)。 |
| 开发、试运行与确认种子 | 互不相交的种子区间。开发种子用于构建和调试,看过即弃;试运行种子检查技术故障;确认种子提供所报告的推断,其结果在协议冻结之前不会被查看。 |
| 人·tick(person-tick) | 一个居民存活一个 tick。“存活人·tick”是同时计入谁活下来以及活了多久的福利度量。 |
6. 研究者如何操纵世界
平台支持四类操纵,本系列都用到了:
- 规则开关。 打开或关闭某条自动规则(家户分食、惩罚、惩罚强度)。
- 世界参数。 改变食物容量、居民数量、再生率、空间禀赋,或由降雨驱动的冲击的变异性。
- 认知与信息处理。 加入注意提示、改变未尝试行动的估值方式、改变居民可观察的内容,或加入私有信念存储。
- 快照处的研究者干预(分叉)。 给予工具或房屋、补充食物、移除某项制度,或强制某个单一行动。这些分叉不是居民的决定。它们衡量一种条件的客观后果(“一件工具值多少?”),与居民是否会选择它区分开。
这种区分至关重要。“免费工具提高存活”这样的结果,并不能说明居民是否会制造或获得工具;后者需要单独的实验,第 2 篇表明二者可能不一致。
7. 实验设计与比较的逻辑
7.1 冻结的协议
对每项研究,都在运行确认种子之前写好协议并保存在版本控制中,协议说明假设、实验臂、种子、结局和决策规则。我们称之为内部预注册。由于版本控制历史是私有的,协议也没有存放到公共注册平台,局外人目前无法核查冻结日期(第 10 节)。协议本身允许后续追加“修订”条目,但修订只追加并注明日期,系列文章会报告试运行之后所做的任何修订。
文章区分三类证据:
- 确认性(预注册主要检验): 在确认运行之前冻结的假设、结局与规则,并做多重检验校正。
- 次要(预先指定、未校正): 列在协议中但不属于校正族。报告其不确定性,从不称为“发现”。
- 探索性或事后: 在看到结果之后定义或注意到。作相应标注,只用于提出问题。
7.2 独立性与样本量
推断单位是世界(种子)。 一个世界内的居民、一个居民的行动、一次运行内的 tick 都高度相关,把它们当作独立样本会大大夸大确定性。每篇文章都说明独立世界的数量,在这里每项比较为 30 到 40 个。行动数、预测数或死亡数作为描述性总数报告,从不用作样本量。
四十个世界是较小的样本。协议指出,它只能在严格阈值下检出大而一致的效应,而不显著的结果不是等效的证据。
7.3 种子配对
由于一个种子的所有实验臂从相同的世界出发,在种子内部比较实验臂,可以去除地图和人口中大量本来会掩盖效应的变异。这是模拟中的配对设计,也类似于模拟方法学中的“共同随机数”[10]。配对并不完美:处理改变事件之后,随机流可能漂移,于是各实验臂的分歧超出处理的直接效应。文章将结果描述为一种操纵在该模型中的总效应(包括下游的行为适应),而不是孤立的机制。
8. 统计分析
所有分析都使用每个世界的配对差值。通用工具如下。
效应量。 处理臂与对照臂的平均配对差值,采用结局的自然单位(每世界死亡数、每世界转移次数、能量单位、人·tick),并同时给出差值为正、为零、为负的世界数。即使均值被少数极端世界主导,这些计数也能显示效应的“一致性”。
置信区间。 基于种子配对的百分位自助法 95% 区间:以固定的随机数生成器对世界有放回地重抽样 10,000 次(照护与休息分叉为 5,000 次),取重抽样均值的第 2.5 与第 97.5 百分位 [11]。区间不含零表示在这种重抽样下平均差值可与零区分。它不是关于真实效应的概率陈述,并且依赖 30–40 个世界能代表模拟器可生成的世界总体。
显著性检验。 对非零配对差值做精确符号检验 [12]。它问的是:如果每个方向的可能性相等,观察到的正负世界数划分有多令人意外。其优点是不作分布假设、对离群值稳健;缺点是忽略差值大小,且差值为零的世界不起作用。主要检验是单侧(协议中冻结了方向性预测)还是双侧,各研究不同;P17–P18 冻结的主要检验族使用单侧精确符号检验,各篇文章说明所用的检验。
多重比较。 在每个冻结的主要检验族内,用 Holm 逐步下降法 [13] 校正 p 值,族整体水平为 0.05。
决策规则。 只有当 Holm 校正后的 p 值低于 0.05,并且 95% 区间完全位于预测方向的一侧时,假设才称为得到支持。当两个标准不一致时,结果被报告为不支持,系列文章刻意展示这类情形,而不是挑选更好看的标准(第 2、3 篇)。有些研究还增加其他标准,例如最低相对改善(第 4 篇)。
预测评分。 对概率预测(第 4 篇),用连续分级概率评分(CRPS)衡量准确度,它是严格适当的评分规则,既奖励准确,也奖励恰当的锐度;越低越好 [14, 15]。
8.1 这里的“p”是什么意思
p 值不是假设为真的概率。这里它是在“世界层面正负差值机会均等”的零假设下,出现至少与所见同样失衡的划分的概率。在潜在样本量极大的模拟中,只要增加世界数,任何一致的差异都可以变得“显著”;项目固定的小样本与固定的决策标准能防范这一点,但小 p 值的含义仍仅限于“这个模型、这些设置”。
9. 如何阅读本系列的一个结果
文章中的每个关键结果都按同一份清单解释:比较了什么;结局变量测量什么、单位是什么;独立世界数;效应的大小和方向;如何解读区间或检验;预先指定的假设是否得到支持;以及这个结果在人工社会内部为什么重要。例如,“儿童饿死数增加了 1.425(95% 区间 1.050 到 1.800;31 个世界更高、7 个相等、2 个更低;Holm 校正 p = 5.2×10⁻⁷)”的意思是:在 40 对其他方面完全相同的世界中,关闭自动家户分食之后,每个 480 tick 的世界平均多饿死约一个半孩子;在 40 对中有 31 对数字上升,这种划分过于悬殊,不能归因于偶然。它并没有说明任何真实的孩子。
10. 意义与局限
10.1 实验能显示什么
在模拟中,实验者拥有田野研究永远不具备的能力:精确复制一个世界、各实验臂相同的起点、强制单一干预、完美的记录,以及仅隐藏状态不同的“双生”世界。这使我们能够对本模型内的因果效应作内部有效的论断,并直接检验相互竞争的机制解释。本系列用这种能力修正早先的解释(例如第 1 篇中撤回的对低重复照护率的解释,以及第 3 篇中更正的死亡率分母)。
10.2 实验不能显示什么
- 外部效度。 居民不是人;能量、食物和冬季规则是简化的;人口很小(通常初始 12 名居民;第 2 篇的一个条件为 192 名)。这里的任何结果都不是关于真实家庭、市场、制度、道德发展或公共政策的证据。把基于智能体的结果外推到人类,需要独立的实证验证 [16, 17]。行为科学也提醒,狭窄样本得到的发现可能错误代表整个人类 [18]。
- 模型依赖。 每个结果都取决于具体的实现选择:照护效用的取值、能量 45 的提示阈值、5% 的探索率、引擎的执行器规则,以及第 3 篇中的提示词。不同的选择可能改变结果。
- 时间跨度短。 48 到 480 个 tick(至多四个模型年)的窗口无法衡量长期或跨代效应。
- 内部效度局限。 协议冻结在私有仓库中;开发种子有时影响了协议选择(各研究分别披露);一些机制仍使用读取隐藏信息的继承捷径(各篇文章分别说明)。
- 没有外部重复。 公布的分析由项目自己完成;本版通过重新计算核对了数据(第 12 节),但没有独立团队复现这些模拟。
- 作者身份与工具。 冻结的协议署名为一个 AI 编码助手起草,模拟与初步分析是在项目负责人指导下完成的。负责人声明这些数据属于他本人。没有独立的人类统计学家或第三方审计者审阅这项工作;引用这些发现的地方都应披露这一点。发布前,负责人应确认作者身份声明的确切措辞。
11. 四项研究一览
| 文章 | 研究 | 独立单位 | 核心发现(限于模型内) |
|---|---|---|---|
| 1. 自主照护 | P10、P11、P12 | 每项研究 40 个配对种子(各 320 个世界);反事实研究 38 个分叉 | 移除自动分食规则使每个世界儿童饿死数增加 1.425;加入照护提示和对未尝试行动的中性价值,挽回了一部分损失;合法信息合同增加了照护转移,却没有明确增加存活。单次被强制的照护行为使所选孩子 48 tick 的存活从 17/38 提高到 28/38。 |
| 2. 工具经济 | P17、P18(以 P16-A/B 为背景) | 每项检验 40 个配对种子 | 在稀缺条件下,免费工具与食物储备有较大的正价值;房屋、互助与交换没有。对 mind9 而言,从零开始制造工具并未被证明能提高存活,因此原计划的学习实验没有进行。 |
| 3. 语言模型居民 | P19 | 两种世界条件下各 30 个配对种子 | 在受限世界中,语言模型居民的福利在全部 30 个世界里都远低于两种基线控制器;在富足世界里相当。私有记忆改变了计划,但没有改变福利。 |
| 4. 有界信念 | P14 | 40 个世界(每个期限 36–37 个合格) | 有界信念预测器在 +1 与 +4 个 tick 上胜过有限历史基线,但没有通过冻结的 +12 tick 门槛,因此没有开展行为实验。一个已知的时间缺陷尚未修复。 |
12. 数据可得性、可复现性与参考文献
证据包。 四个发布候选包随文章提供:P10–P12、P17–P18、P19 和 P14(清单与包内内容的文件数量并不完全一致,见证据审计)。其中包含冻结的协议与报告、已核验的汇总结果、逐世界结果行、分析脚本和图表数据,采用 CC BY 4.0(数据、图表、文档)与 MIT(脚本)许可,不含模拟引擎和私有基础设施。P19 包仍因尚未解决的第三方权利问题被标记为 PUBLICATION_BLOCKED,暂不提供下载;按负责人的决定,P19 文章仍写明所研究的模型(DeepSeek-V4.1-Flash-1017,API 模型名 deepseek-flash)。P10–P12、P17–P18 和 P14 三个数据包(1.0.0 版)可在各自文章页和研究数据档案页下载。
能复现什么。 汇总统计可以由提供的逐世界结果行重新计算。为本版,四项研究的主要统计量都已由这些结果行独立重新计算,并与冻结的分析一致(次要对比的置信限在重抽样噪声范围内一致)。已发布的分析脚本导入了未分发的模块,因此完整分析流程无法由包重新运行;模拟本身也无法重新运行,因为引擎、依赖锁定文件、逐 tick 事件流和模型版本快照按设计未包含在内。
建议引用格式(临时)。 SHING CIVITAS 项目(2026)。《SHING CIVITAS 研究系列》(v3.0)。https://shingcivitas.com/。作者姓名、DOI 和最终引用元数据尚未确定,须由负责人提供。
参考文献
以下外部文献已于 2026-11-12 对照出版社、期刊、会议论文集、DOI 或图书馆记录核验。它们仅支撑理论背景和研究方法,不构成对 SHING CIVITAS 实验结果的外部验证。
- 1Schelling, T. C. (1971). Dynamic models of segregation. The Journal of Mathematical Sociology, 1(2), 143–186. https://doi.org/10.1080/0022250X.1971.9989794
- 2Epstein, J. M., & Axtell, R. (1996). Growing Artificial Societies: Social Science from the Bottom Up. Brookings Institution Press / MIT Press. https://www.brookings.edu/books/growing-artificial-societies/
- 3Axelrod, R. (1997). The Complexity of Cooperation: Agent-Based Models of Competition and Collaboration. Princeton University Press. https://press.princeton.edu/books/paperback/9780691015675/the-complexity-of-cooperation
- 4Epstein, J. M. (2008). Why model? Journal of Artificial Societies and Social Simulation, 11(4), 12. https://www.jasss.org/11/4/12.html
- 5Park, J. S., O’Brien, J. C., Cai, C. J., Morris, M. R., Liang, P., & Bernstein, M. S. (2023). Generative agents: Interactive simulacra of human behavior. Proceedings of UIST ’23, Article 2, 1–22. https://doi.org/10.1145/3586183.3606763
- 6Piatti, G., Jin, Z., Kleiman-Weiner, M., Schölkopf, B., Sachan, M., & Mihalcea, R. (2024). Cooperate or collapse: Emergence of sustainable cooperation in a society of LLM agents. Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://proceedings.neurips.cc/paper_files/paper/2024/hash/ca9567d8ef6b2ea2da0d7eed57b933ee-Abstract-Conference.html
- 7Ashery, A. F., Aiello, L. M., & Baronchelli, A. (2025). Emergent social conventions and collective bias in LLM populations. Science Advances, 11(20), eadu9368. https://doi.org/10.1126/sciadv.adu9368
- 8Horton, J. J., Filippas, A., & Manning, B. S. (2023; revised 2026). Large language models as simulated economic agents: What can we learn from Homo silicus? NBER Working Paper No. 31122. https://doi.org/10.3386/w31122
- 9Simon, H. A. (1955). A behavioral model of rational choice. The Quarterly Journal of Economics, 69(1), 99–118. https://doi.org/10.2307/1884852
- 10Law, A. M. (2015). Simulation Modeling and Analysis (5th ed.). McGraw-Hill. https://www.mheducation.com/highered/product/simulation-modeling-and-analysis-law
- 11Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- 12Dixon, W. J., & Mood, A. M. (1946). The statistical sign test. Journal of the American Statistical Association, 41(236), 557–566. https://doi.org/10.1080/01621459.1946.10501898
- 13Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- 14Matheson, J. E., & Winkler, R. L. (1976). Scoring rules for continuous probability distributions. Management Science, 22(10), 1087–1096. https://doi.org/10.1287/mnsc.22.10.1087
- 15Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. https://doi.org/10.1198/016214506000001437
- 16Windrum, P., Fagiolo, G., & Moneta, A. (2007). Empirical validation of agent-based models: Alternatives and prospects. Journal of Artificial Societies and Social Simulation, 10(2), 8. https://www.jasss.org/10/2/8.html
- 17Grimm, V., Railsback, S. F., Vincenot, C. E., et al. (2020). The ODD protocol for describing agent-based and other simulation models: A second update to improve clarity, replication, and structural realism. Journal of Artificial Societies and Social Simulation, 23(2), 7. https://doi.org/10.18564/jasss.4259
- 18Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
核验登记: 参见 附录 C · 文献核验登记,含各条来源链接、著录更正和核验边界。